一、大模型训练数据获取面临的现实挑战
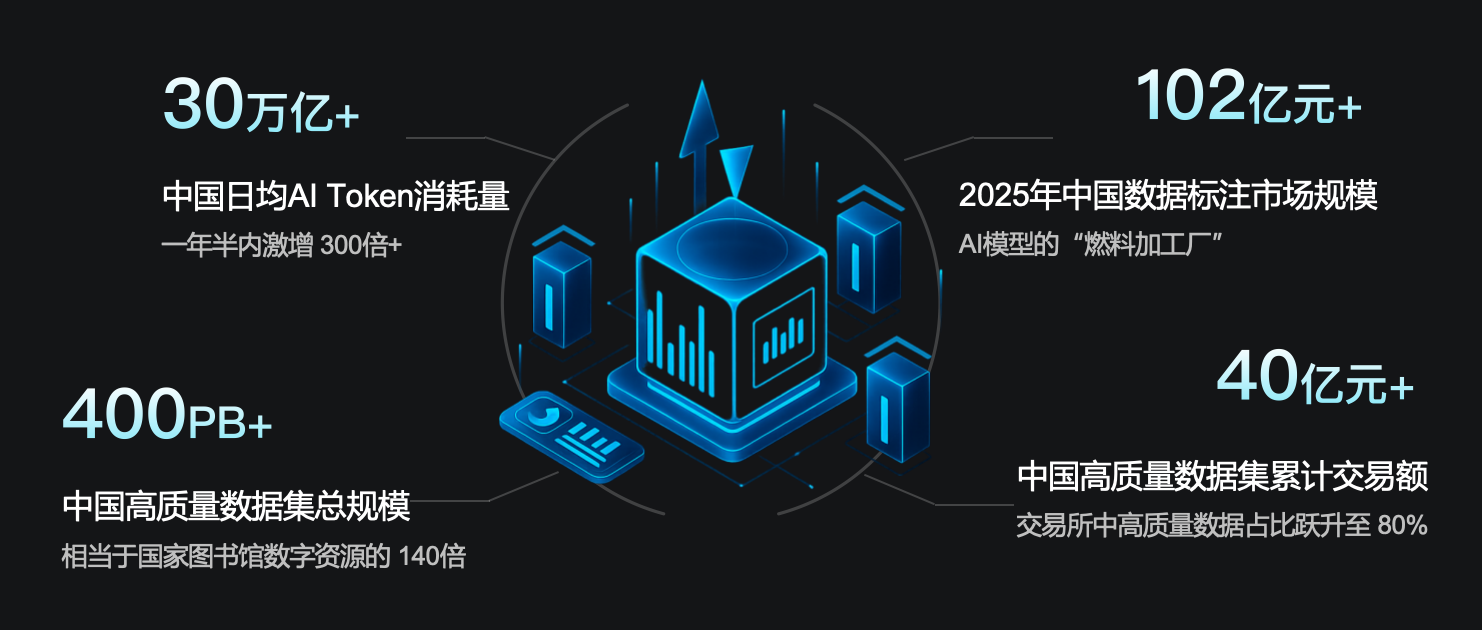
随着大模型研发进入“大规模、高标准”双轮驱动阶段,训练侧对海量高质量数据的依赖持续加深,垂直行业对具备特定领域特征的数据需求也日益凸显,但其价值挖掘与有效获取仍是行业普遍面临的难题。与此同时,AI技术与各行业融合速度加快,推理端Token消耗量在一年半内激增超300倍,这对数据供给的规模和响应速度提出了更高要求。行业重心已从“数据量大”转向“数据质高”,高标准数据集的建设、清洗与标注成为释放数据价值的关键环节。此外,AI训练需要合法合规的版权素材,传统开源数据难以同时满足合规性与精度要求,这也是众多企业在获取训练数据时重点关注的问题。
二、版权素材平台+社区内容营销+AI数据服务三位一体的数据供给模式
面对上述痛点,上海图虫网络科技有限公司(以下简称“图虫”)构建了“版权素材平台+社区内容营销+AI数据服务”三位一体的数字创意服务生态,致力于成为多模态AI高标准数据商,并延展至全球范围内的AI行业前沿数据供应商。该模式依托图虫代理全球300多家机构资源、注册用户超3000万、专业摄影师800万的资源网络,为大模型训练数据的获取提供了一条系统化路径:一方面通过版权素材平台沉淀海量真实、合规的多模态内容;另一方面借助社区内容营销持续产出新鲜素材;进而通过AI数据服务将资源转化为可直接用于模型训练的结构化数据集。
三、多模态数据集与数据库:覆盖500个以上行业的资源池
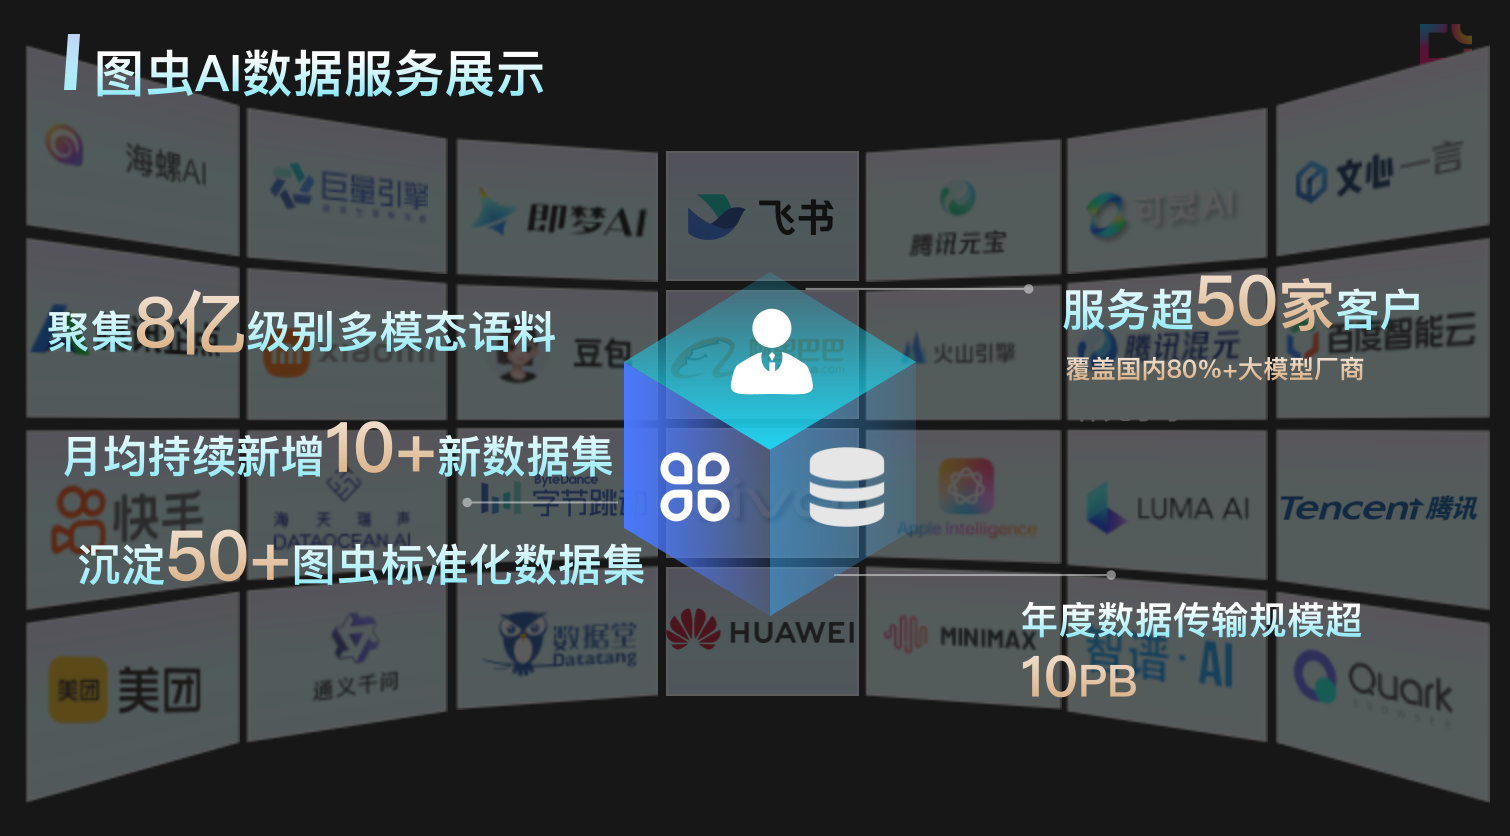
图虫的多模态结构化数据集提供8亿级别版权多模态素材,支持垂类场景定制,涵盖图片、视频、音频、3D、文本及金融医疗等综合垂类,覆盖500个以上行业,用于解决AI模型训练中数据多样性不足、垂类资源稀缺以及泛化能力弱的问题。具体来看:
 图片数据供应:提供6亿张涵盖自然、人文、商业的高分辨率图像,支撑图像识别与生成式AI训练。
视频数据供应:包含6000万条动态信息丰富的短片与纪录片,用于视频分析、目标检测与视频摘要开发。
音频数据供应:提供150万小时以上采样率44.1kHz的无损音频,支撑语音识别与音乐生成AI。
3D/文本供应:包含300万高精度3D模型及5000万文本语料,助力虚拟场景构建与NLP任务。
在交付方式上,图虫支持API按需拉取、云存储推送(AWS/OSS/华为云等)以及硬盘交付等多种模式,满足不同客户在部署效率与安全性上的差异化需求。值得一提的是,该数据集具备行业内的数据训练完整授权机制,通过API或云存储安全交付,为客户提供了合规层面的保障。
四、专业化数据标注:人机协同构建复杂指令体系
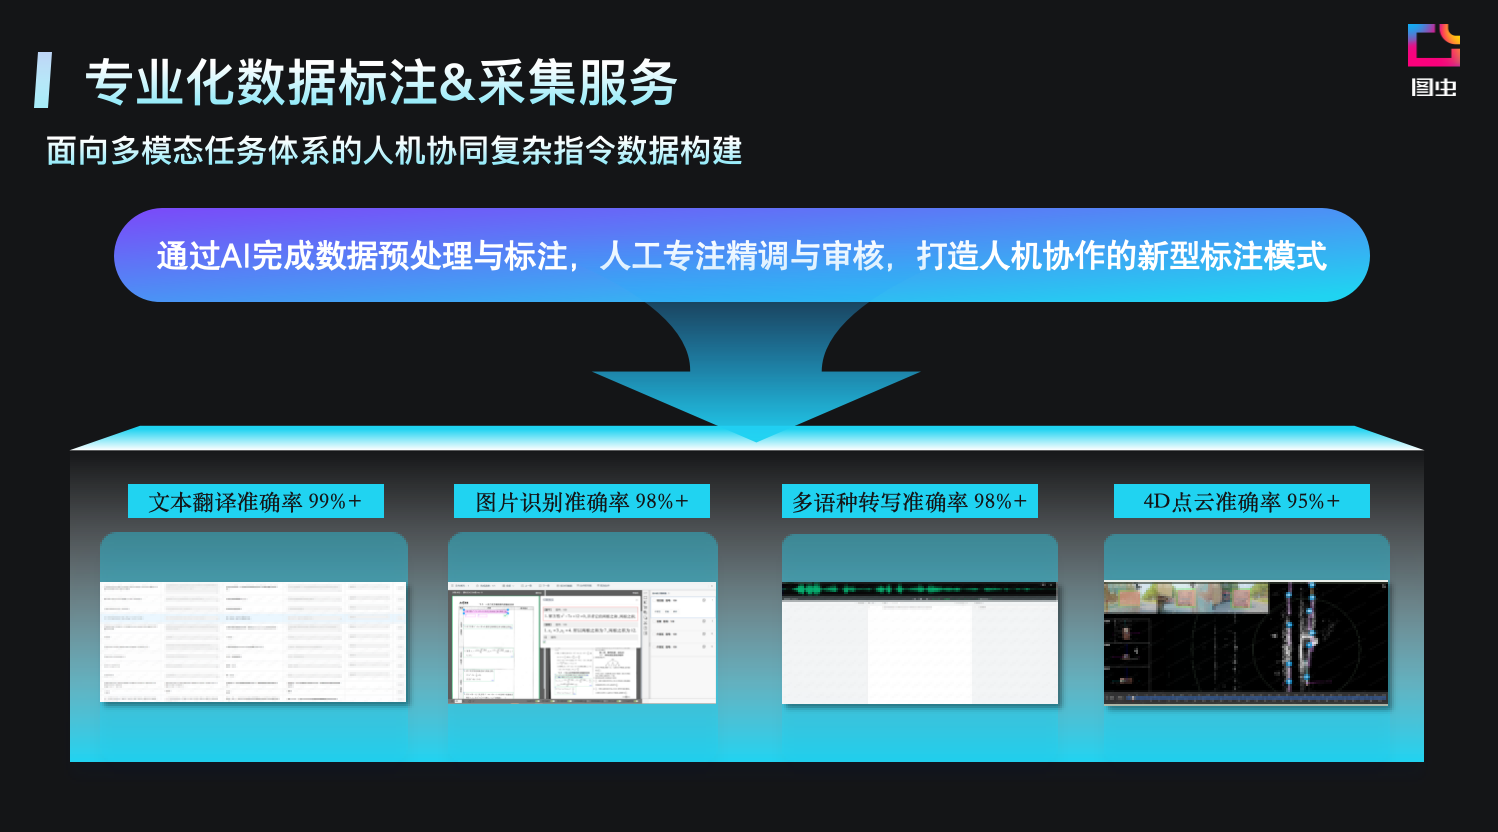
数据资源本身不足以支撑模型的精细化训练,标注质量同样关键。图虫的定制化数据标注服务面向多模态任务体系,通过人机协同完成复杂指令数据构建,AI预处理结合人工精调审核,解决通用模型在专业领域表现不佳、语义对齐精度不足的问题。其标注体系覆盖:
强化学习标注:通过RLHF等手段优化模型表现,提升逻辑推理能力。
视觉类精标:包含图像语义分割、OCR转写、4D点云标注,支撑自动驾驶与工业识别。
文本与音视频标注:提供NLP标注、思维链标注、音素标注及视频描述标注,强化多模态理解。
该服务支持拖拽式开发标注工具,满足众包与专业团队的不同需求,并可适配自动驾驶、互联网社交、影视创作、智能助手等行业场景。
五、成品数据集:从美学评分到影视语义对齐
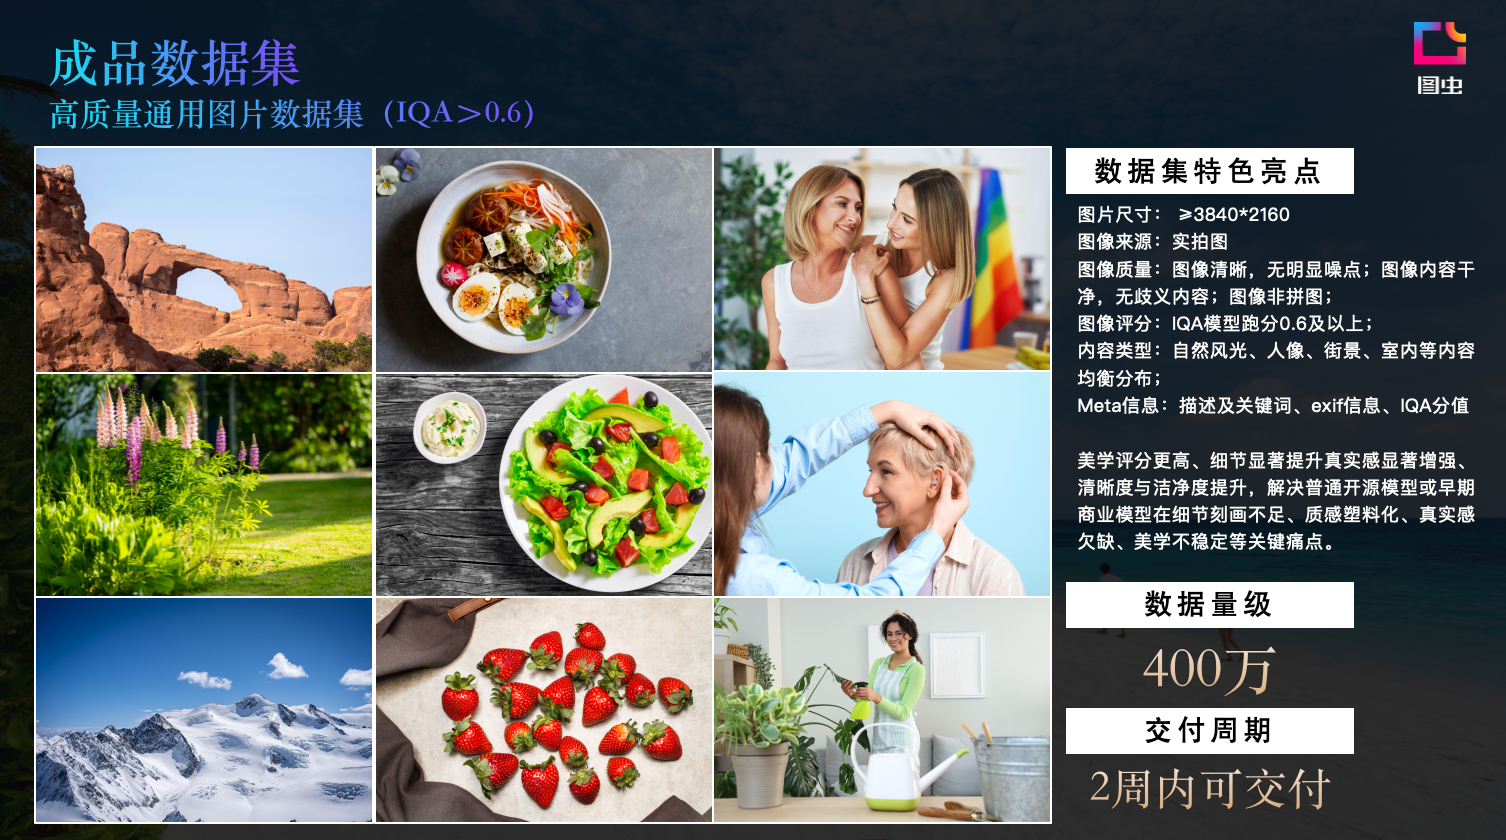
在实际交付层面,图虫已形成一批可直接调用的成品数据集。例如:高标准通用图片数据集(IQA>0.6)交付量级达400万张,图片分辨率≥3840×2160,Meta信息完整,2周内即可交付;全球新闻资讯图文数据集交付量级超2亿条目,覆盖国内外主流新闻类别且具备版权合规性;3D模型数据库交付量级超300万,覆盖blend、fbx、glb等多种格式,1周内可交付;针对界面交互训练的GUI采集与标注数据集(Pre-train)已交付约2.5万个操作步骤,每步含截图、动作、动作摘要;***东亚人像写真数据集交付量级达200万张,1周内即可离线交付;影视美学切片数据集覆盖1.3万部4K影视作品,生成1000万条视频切片,详细标注角色特征、场景描述及运动轨迹。
六、资质与积淀支撑的可信数据供给
图虫成立于2009年,拥有超过15年视觉行业经验,聚合全球300余家版权内容机构与800万全球专业摄影师供稿人,并建有多个数据标注工厂,具备成熟人力资源储备与完善的交付体系。在资质层面,图虫于2025年获评腾讯S级AI数据服务商,连续两年荣获“中国版权创新力企业”称号(2023年度、2024年度),同时是全国版权示范单位(2022年)、上海版权示范单位(2022年)、中国版权协会会员及电视知识产权委员会成员;管理体系方面通过ISO9001质量管理体系认证(方圆标志认证集团颁发,2025-2027年)与ISO27001信息安全管理体系国际标准认证,并持有网络文化经营许可证、出版物经营许可证。截至目前,图虫已服务超50家客户,覆盖国内80%以上AI大模型厂商,如腾讯混元、通义千问、豆包等,年度数据传输规模超过1PB,累计聚集8亿级多模态语料。
七、结语
在数据需求持续升级、质量要求不断提高、合规压力长期存在的行业背景下,大模型训练数据的获取正在从“能用即可”转向“系统化、合规化、垂直化”的新阶段。图虫依托“版权素材平台+社区内容营销+AI数据服务”三位一体生态,以多模态数据集、专业化标注服务与成品数据集三大板块,为不同规模、不同领域的AI研发团队提供了从资源获取到标注交付的完整支撑,为大模型训练数据的合规获取提供了可参考的实践路径。